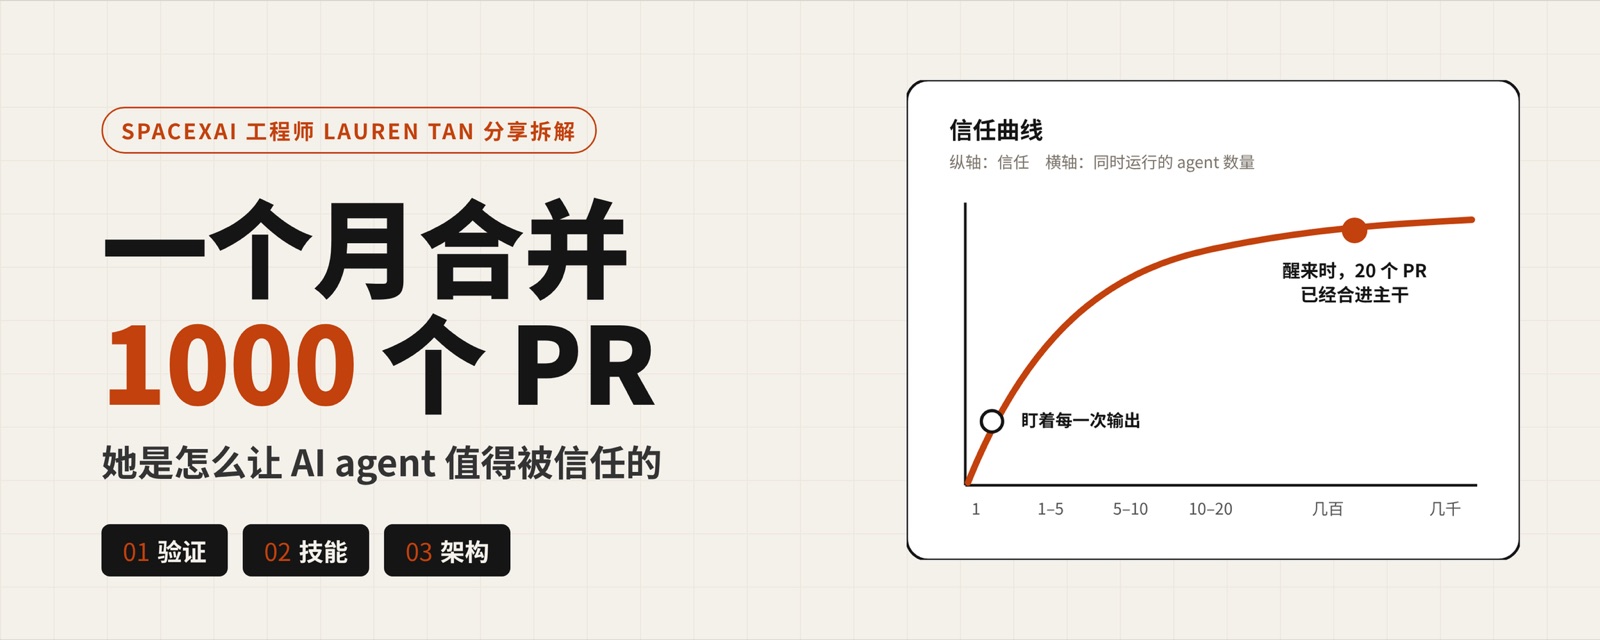
目录
- Lauren Tan,SpaceXAI 软件工程师
- 她的 GitHub 贡献图:五个月 3000 多个 PR
- 一、先看一条曲线
- 她手绘的信任曲线,横轴是同时运行的 agent 数量
- 二、第一块地基:让 agent 自己验证
- control glass 技能的 SKILL.md
- 真正关键的是一份功能地图
- 功能地图:从用户视角写清每个功能怎么到达
- 三、第二块地基:把工程经验写成技能
- 技能也要写测试
- 四、从本地走到云端
- Benny 的回复:能复现,但 main 上已经修好了
- 先承认 agent 的习惯
- Dune 设计文档:先写清 agent 的行为习惯
- 几条具体的禁令
- 六、五层约束,只有前两层算数
- 代码库本身的结构和约定
- 静态分析:lint、编译器、CI
- 技能
- 风格指南
- Dune 的五条规则,下方是她手写的约束分层
- PR 拆小一点
- 她演示的 PR 列表:CI 失败、已合并、已关闭
- 七、这笔 token 账划算吗
- 八、最后的回报
- 如果你明天就想开始
先谢谢 Lauren Tan 把这套方法毫无保留地讲了出来。五个月里踩过的坑、一个个写出来的技能、重构 Grok Bot 用掉的 600 多个 PR,她在 50 分钟里全摊开了,连 eval 时怎么防止 agent 发现自己在被测试这种细节都没藏着。这样的分享很少见,再次谢谢 Lauren Tan。
也谢谢 @akarixbt 把完整视频搬到 X 上,不然我大概也刷不到。干货满满。
Lauren Tan 在分享里提到一件事:今天早上醒来,主干上已经多了 20 个 PR。都是她的 agent 夜里自己写、自己验证、自己合进去的。她起床以后直接在 main 上 review,挑不出什么毛病。
Lauren Tan,SpaceXAI 软件工程师
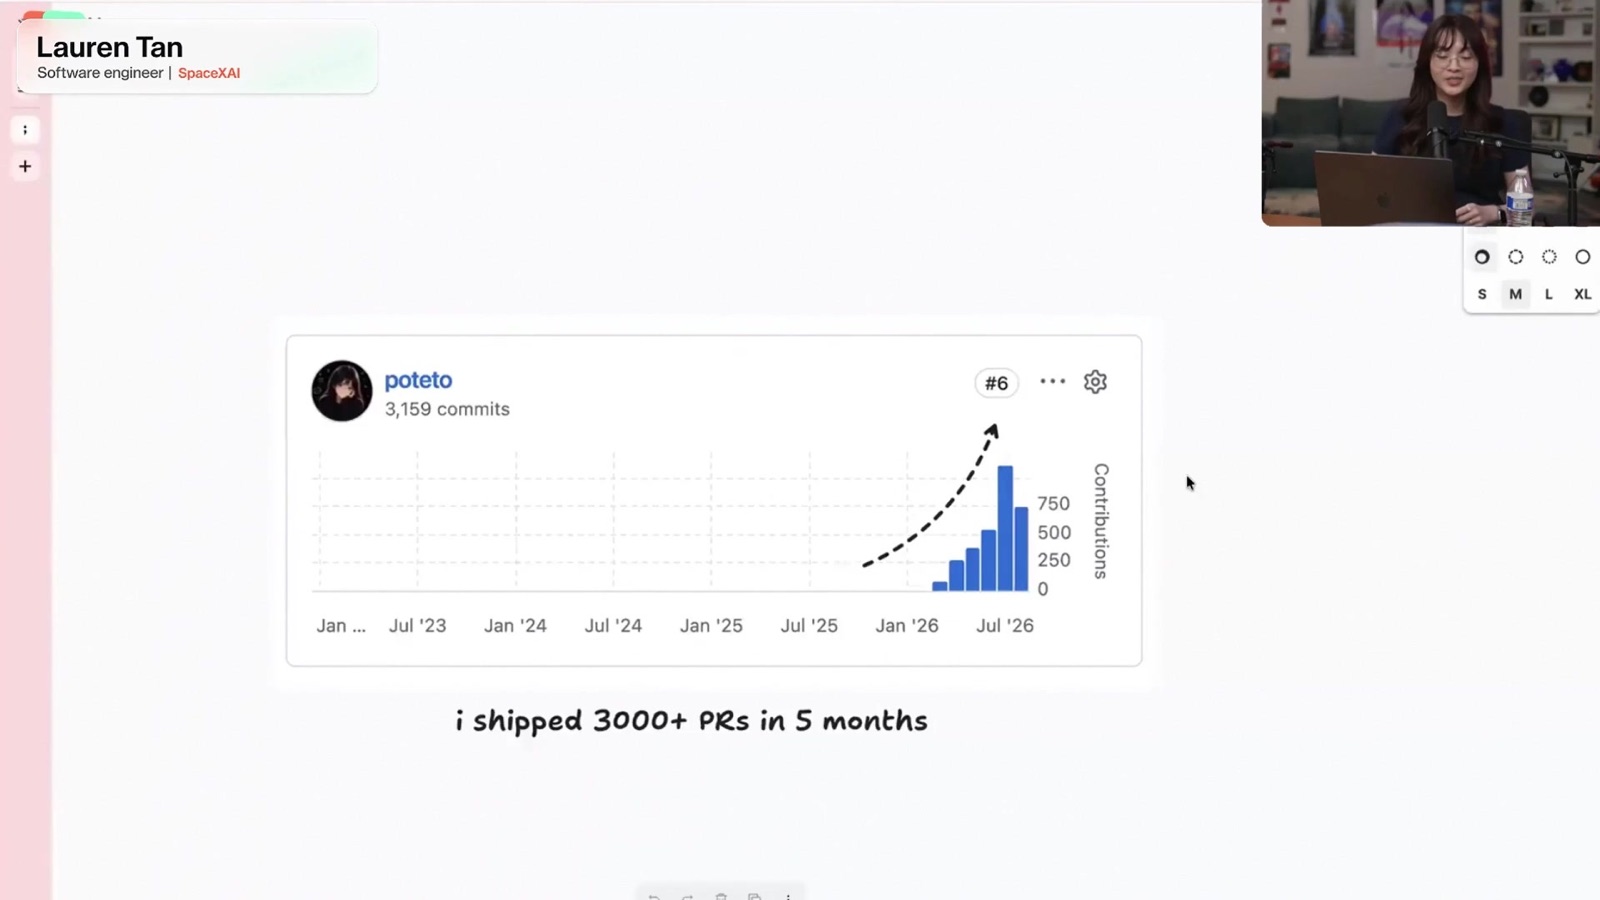
她自己也知道这话听起来很危险,像一个只会生产垃圾代码的人在吹牛。所以她马上补了数据:五个月前加入 Cursor,第一个月几乎没什么产出,五个月下来一共合并了 3000 多个 PR。光上个月就有 1000 个,这个月到 12 号已经接近 800 个。她现在在 SpaceXAI 做 Grok Bot,更早之前在 Meta 待过很多年。
她的 GitHub 贡献图:五个月 3000 多个 PR
这场分享 50 多分钟,没有讲 prompt 技巧,从头到尾只回答一个问题:怎么才能信任你的 agent。
下面按她的原话和演示,把整个方法拆开讲。
一、先看一条曲线
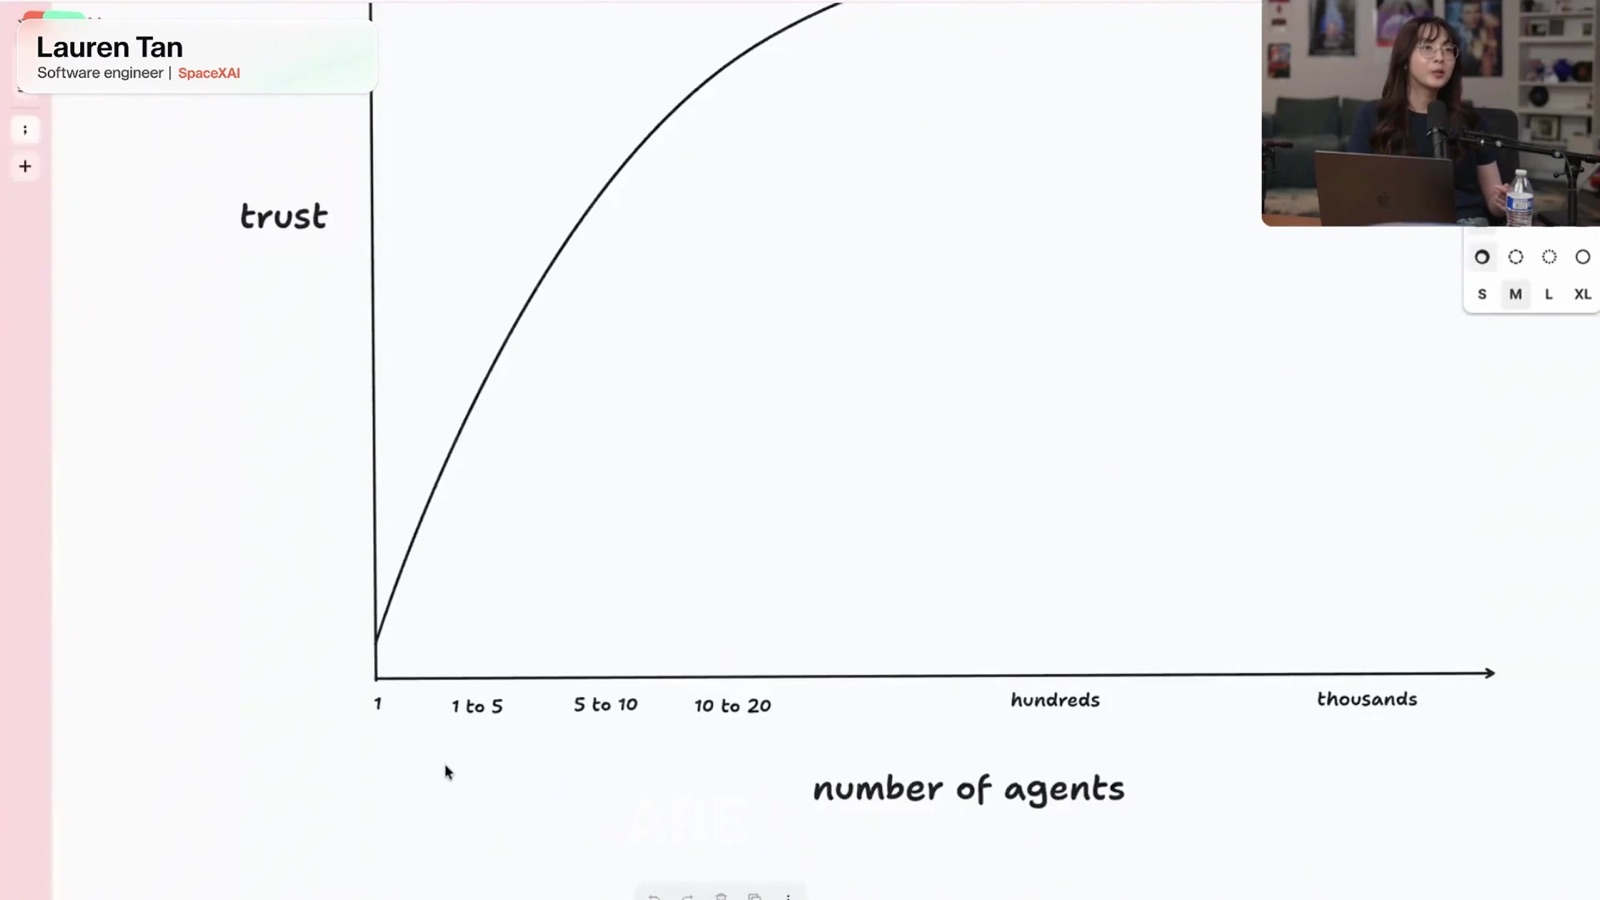
她在白板上画了一张图。横轴是同时运行的 agent 数量:1 个、1 到 5 个、5 到 10 个、10 到 20 个、几百个、几千个。纵轴是信任。
曲线是先陡后平的。她说这张图不科学,但它就是她这五个月的真实路径。
她手绘的信任曲线,横轴是同时运行的 agent 数量
她用管理来类比。如果你是一个工程经理,但你不信任团队里的任何人,你就只能微观管理:盯着每个人的屏幕,检查每一行代码,担心谁又把 bug 推上了生产环境。这种状态下,团队人数再多也没用,因为瓶颈是你自己。
用 agent 也一样。一年前大多数人的状态是:开一个或者几个 agent,盯着每一次输出,不停地追问它在干什么。你连一个 agent 的结果都不信,就不可能同时开一百个。
你不可能在连一个 agent 都不信任的时候,去同时开一百个 agent。
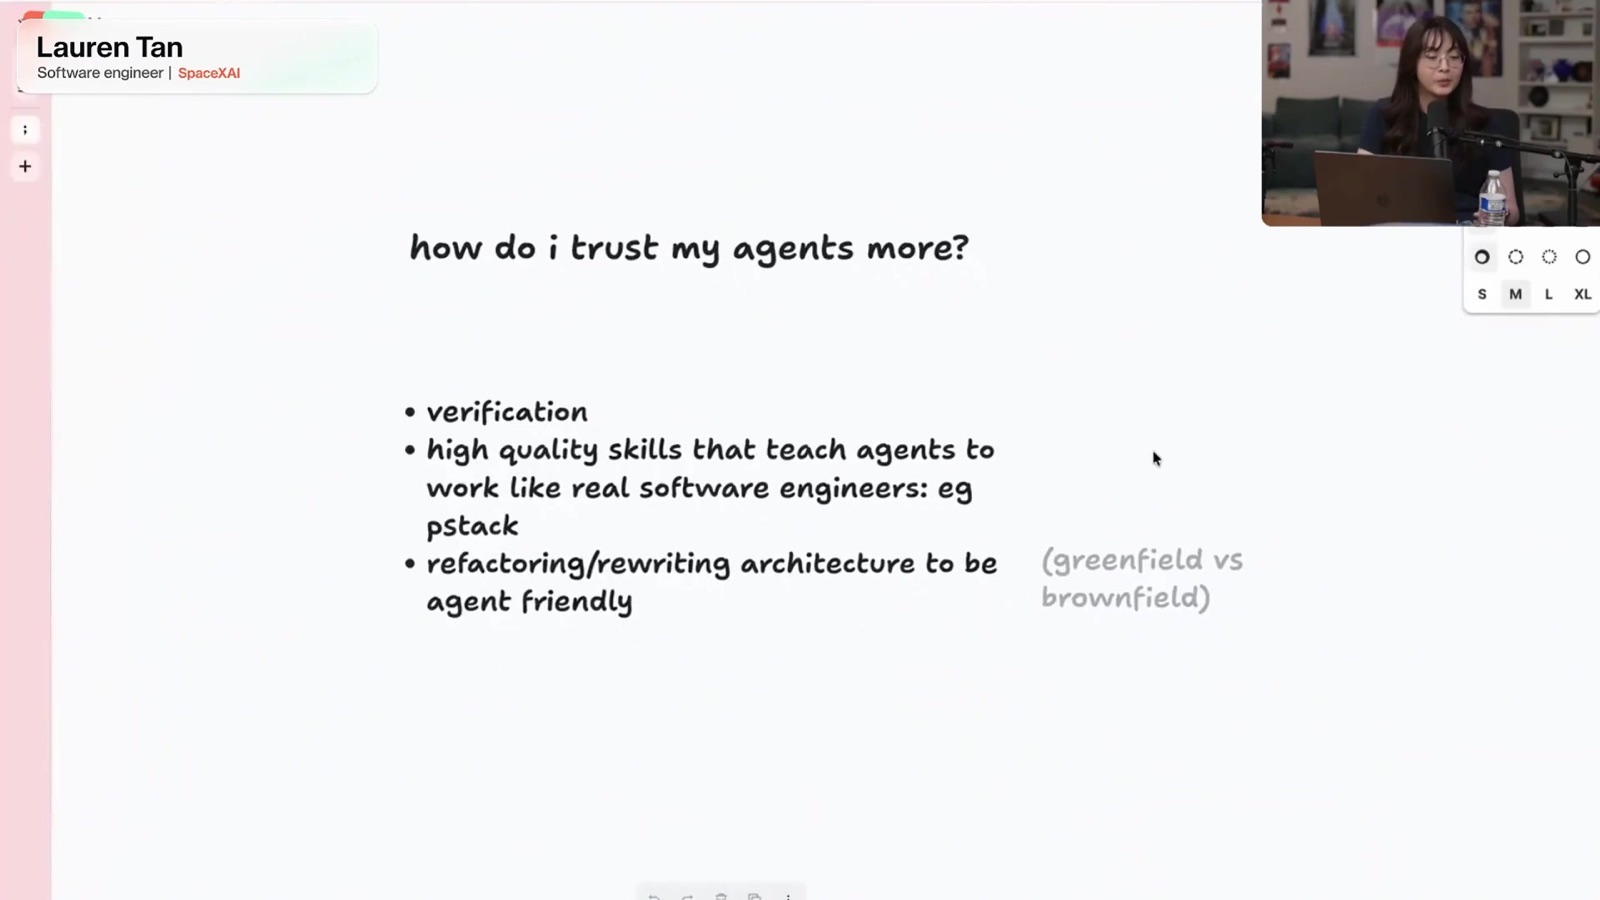
她给出的爬坡方法有三块:验证能力、高质量的技能、对 agent 友好的架构。后面每一节对应其中一块。
怎么更信任 agent:验证、高质量技能、对 agent 友好的架构
二、第一块地基:让 agent 自己验证
她认为跟 agent 合作时,工具箱里最重要的一项能力是验证。
这里的验证指的是 agent 能像真实用户一样把程序跑起来:打开应用、点击、截图、抓 CPU trace、拍内存快照、开 iOS 模拟器。你的产品以什么方式暴露给用户,agent 就要能用同样的方式去操作和检查。
验证不保证 agent 写出好代码,但能保证它写出正确的代码。这是建立信任的第一步。
她讲了自己入职第一周的经历。当时她被临时调去支援 Cursor 的 agents window(内部代号 Glass),一周后就要发布,任务是做性能优化。她对代码库完全陌生,只能打开 Chrome DevTools 抓 trace,盯着火焰图看。然后把截图发给 agent,agent 每次都很自信地说找到了根因,她去改,发现根本不是那个问题。
她说这种状态下,你就是那个验证者,也是整个流程的瓶颈。agent 写完代码,你打开本地构建,发现不对,再复制截图和控制台日志喂回去。你一直被困在循环里,没办法并行。
于是她做了第一个技能:control glass。它教 agent 通过 Chrome DevTools Protocol 驱动一个正在运行的开发版 Cursor:检查 DOM、截图、点击、输入、读无障碍树、跑 JS profile、模拟 CPU 和网络降速、读取控制台和网络日志,还能在隔离的 worktree 里并行启动多个实例。
control glass 技能的 SKILL.md
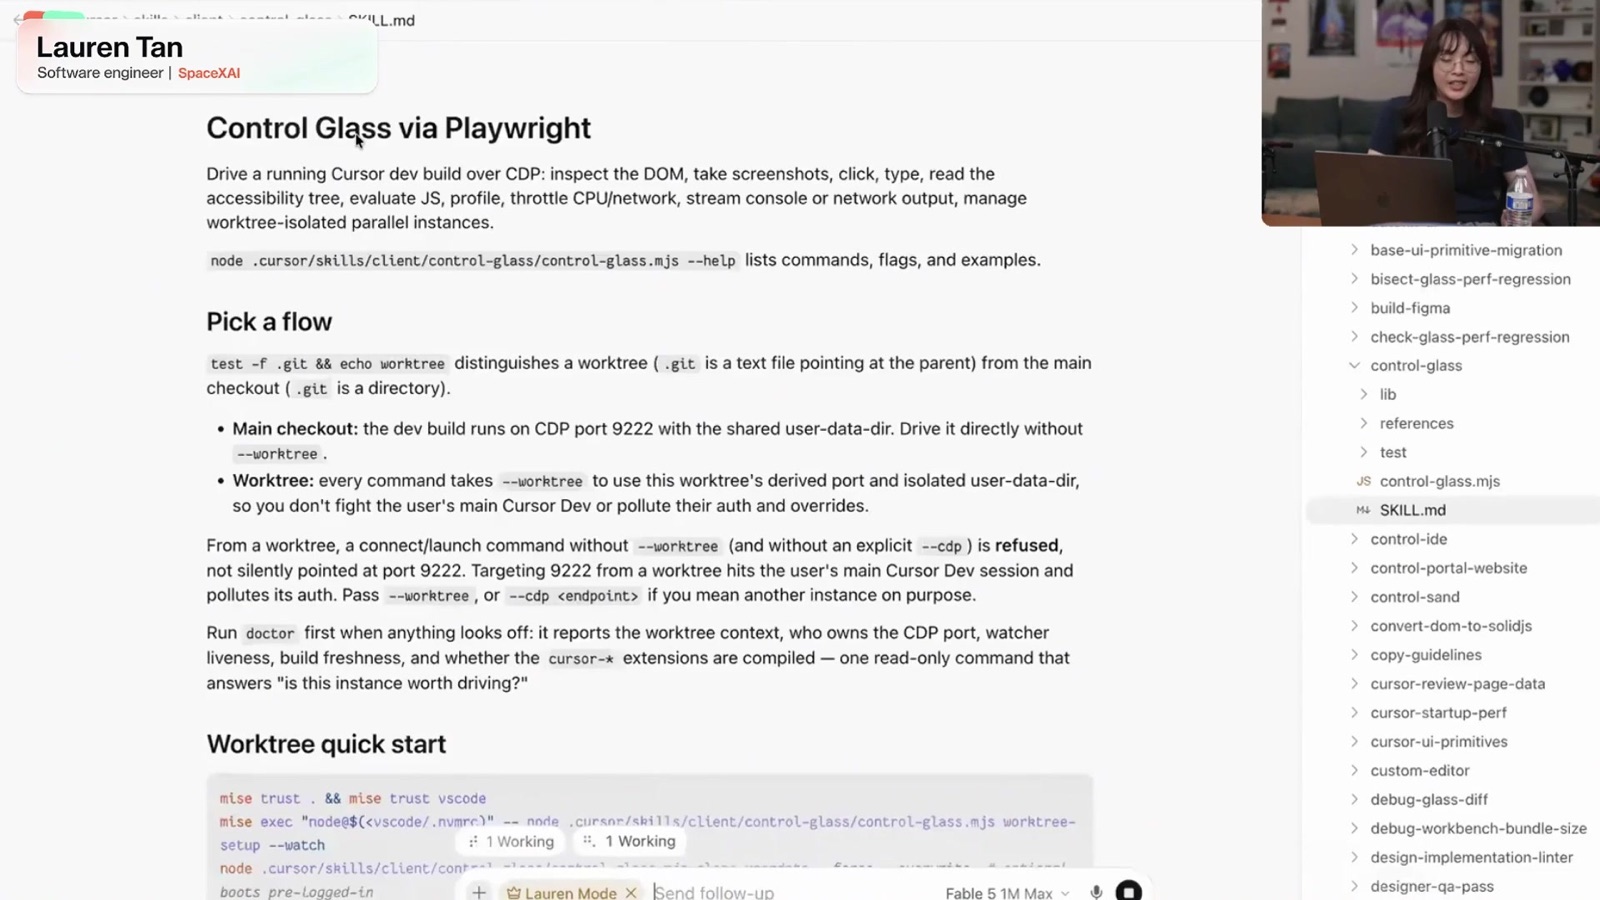
她说这个技能的代码本身没什么特别,让 agent 帮你写一个很容易。Electron、Web、iOS 都有现成的程序化控制方式。
真正关键的是一份功能地图
技能做出来以后,agent 能把应用跑起来了,但它不知道应用里有什么。有人报告说左边栏卡顿,或者右边的 PR 标签页坏了,agent 就开始满代码库乱翻,找不到这个功能在哪,也不知道在界面上怎么点到它。她形容那个体验糟糕透了。
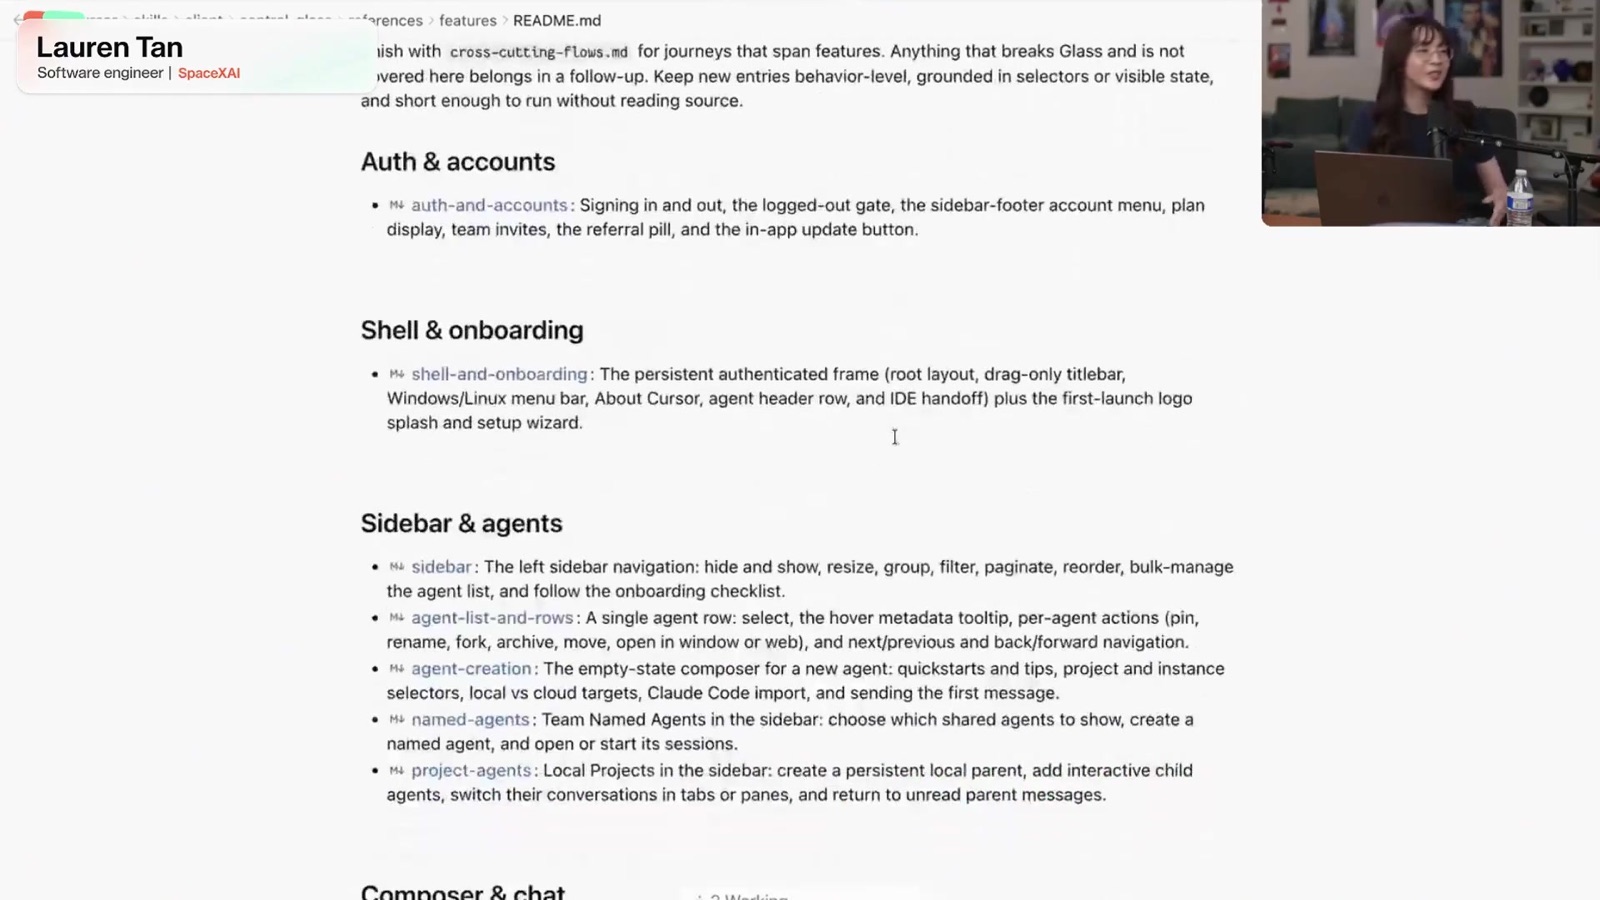
解决办法是给技能配一份 feature map,也就是功能地图。一个功能一个文件,从用户视角写清楚:这是什么功能,怎么在界面上找到它,有哪些子功能,快捷键是什么,用来定位元素的 DOM 属性是什么。另外还有一份基础前置条件,比如开发版必须在运行、侧边栏里至少有一个 agent、不能有弹窗挡着。
功能地图:从用户视角写清每个功能怎么到达
有了这份地图,质量很差的反馈也能用了。Cursor 内部有个 Slack 频道专门收反馈,很多人只发一张截图,配上三个问号。没有地图,agent 完全无从下手。有了地图,它能把截图对应到具体功能,再自己点进去复现。
她把这套做法放进了自己开源的插件 pstack,里面有一个 create verification 技能,会自动探索你的代码库,生成初版功能地图。还有一个 maintain verification 技能,负责随着产品迭代把地图更新下去。
三、第二块地基:把工程经验写成技能
pstack 这个名字有点来历。YC 的 CEO Garry Tan 做过一个插件叫 gstack,她刚好也姓 Tan,两人没有任何关系,于是她就做了一个 potato stack,简称 pstack,算是开个玩笑,内容是按她自己的工程习惯定制的。
她说自己从来没计划要做一个插件。它是从一个个技能慢慢长出来的,而每个技能都来自她观察到的一种失败模式。
比如早期她发现,agent 经常信誓旦旦地说「问题一定出在这里」。她去翻 agent 的工具调用记录,发现它根本没读过那段相关的代码。她当时对这个 agent 的信任直接归零。
但她没有停在不信任上。她又用了一次管理的类比:假设你招了一个代码能力很强、但完全没有业务背景的工程师,他五秒钟前刚入职。你要怎么让他变得有用?你会把经验教给他。
对 agent 来说,教的方式就是技能。技能本质上就是一份 markdown,但它能装进大量的经验和指令。她的解释是,大模型是在预测下一个 token,你先给它一段高质量的 token,它就会往更聪明的方向去匹配。
所以她的做法很朴素:每发现一种失败模式,就把它写成一个技能。别瞎猜,先去读代码,多用子 agent,停止猜测。
至于怎么发现失败模式,她的建议是当一个好的副驾驶。像结对编程时看同事写代码一样,主动去展开 agent 的每一次工具调用,读它的思考过程,看它在哪里走偏,然后针对那个地方写技能。在建立自己技能库的早期,你需要坐在驾驶座上,不能只当旁观者。
技能也要写测试
技能写完以后,怎么知道它真的有用?她的答案是 eval。她的理解是,eval 就是给 agent 写的单元测试,不需要任何专门的框架,看你想做得多严谨。
pstack 里有一份 eval playbook,流程大概是这样:
主控 agent 先为这个技能写一份评分标准。
主控 agent 派出一批子 agent 去执行任务,每个子 agent 有自己独立的目录。
目录名称要刻意起得很普通,不能让子 agent 发现自己正在被测试。她说 agent 能察觉到自己在被评估,察觉到以后行为就会变。
用不同的模型分别跑一遍,看技能在各个模型上的表现。
再找一个不同模型的 judge agent 交叉打分,避免同一个模型给自己打高分。
有了分数,就可以爬坡。她会在 Cursor 里用 /loop 让 agent 反复跑这个 eval,直到所有项都拿到 10 分。control glass 的命令行工具就是这样迭代出来的,过程中她几乎没怎么插手。
她说维护技能其实很难,需要大量的品味和观察。每次改技能,她都会重新跑一遍 eval。
四、从本地走到云端
被问到如果自己想搭一套验证系统该从哪开始,她的回答是先在本地做。本地能看到 agent 是怎么启动应用、怎么调用接口、怎么跟界面交互的。看清楚了,才谈得上信任。
她自己现在基本全在用云端 agent。原因是验证技能一旦在云端环境里配好,收益就不只属于你一个人,整个团队甚至整个公司都能用。
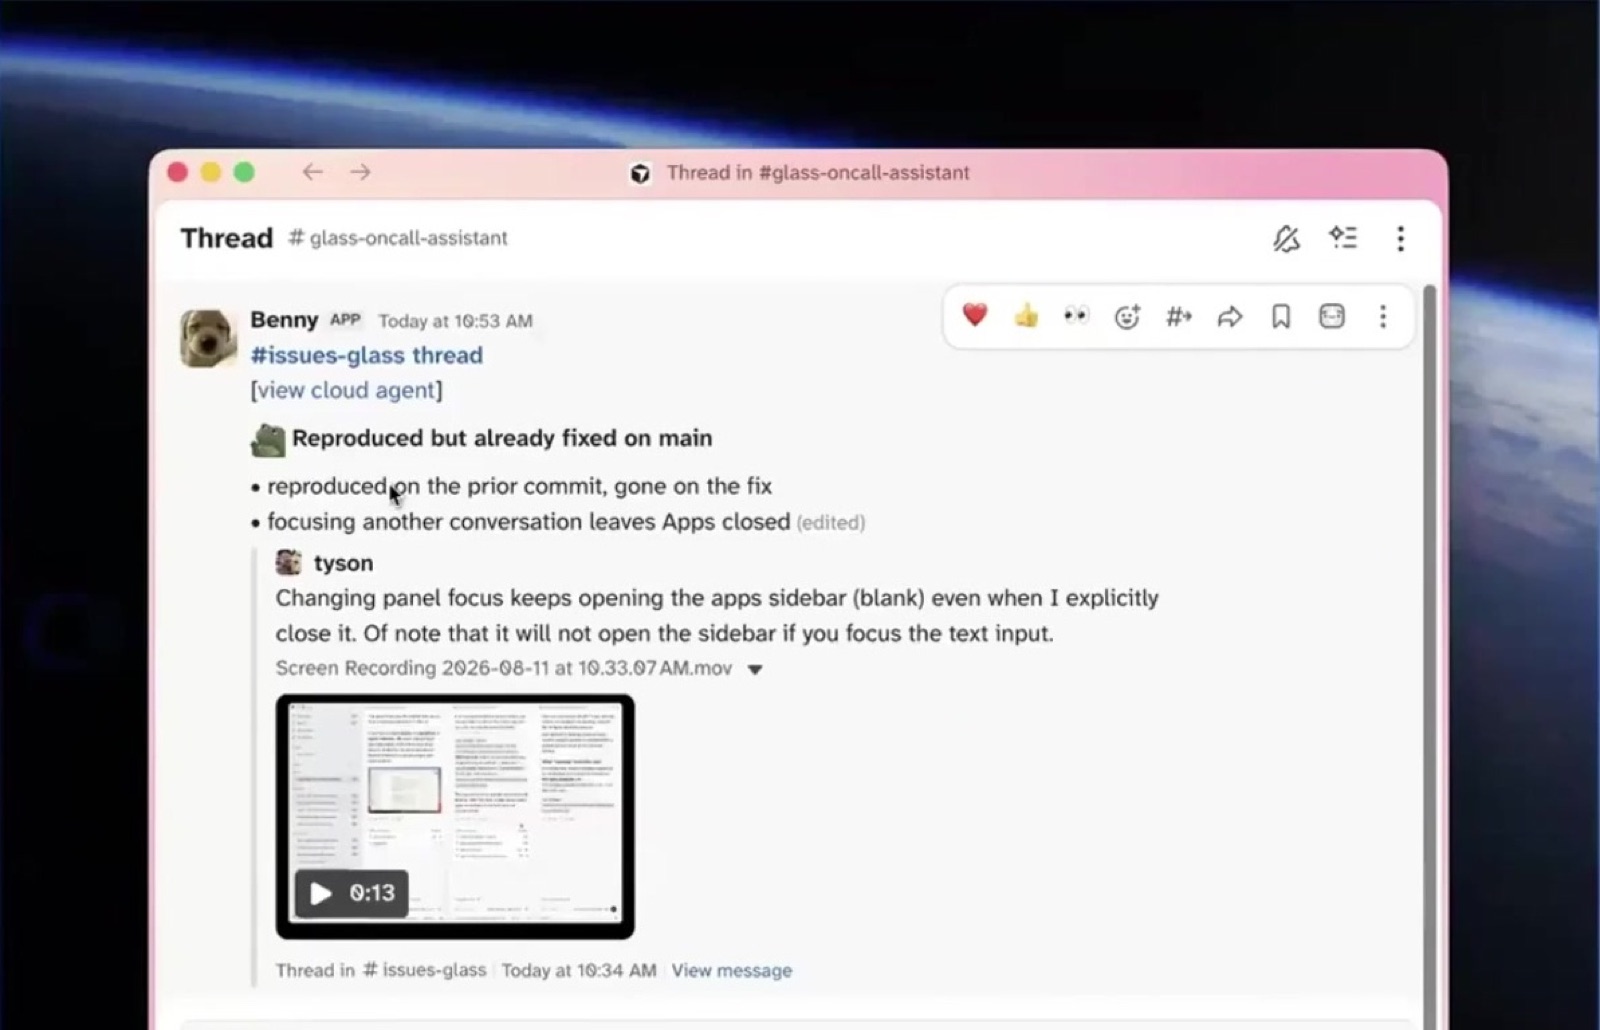
她举了一个例子:Cursor 内部有一个叫 Benny 的 agent。用户反馈进来以后,Benny 会自动在云端开一台桌面,在上面运行 Cursor,用同一套 control 技能去复现问题。她展示的一次结果里,Benny 回复说问题能复现,但在最新的 main 上已经修好了。这意味着团队只需要发一个新版本,不用再有人坐下来花一个小时确认这个 bug 到底修没修。
Benny 的回复:能复现,但 main 上已经修好了
但她特别提醒,不要跳级。如果你现在还处在曲线左下角,一次只敢开两三个 agent,就别想着马上开几百几千个云端 agent,那只会烧掉大量 token,代价非常高。
她把现在的工程师比作餐厅的主厨。主厨已经不亲手做每一道菜了,手下有帮厨、副主厨和各个工位。主厨的工作是设计厨房、安排分工。
五、第三块地基:让架构对 agent 友好
这是整场分享里她最想多讲的一部分。
她先抛出一个行业里最有争议的问题:该不该重写?工程师刚进一家公司,看到代码库,第一反应往往是「这谁写的,全部重写」。过去大多数人会劝你别重写,但她这次想为重写说几句话,前提是要分清楚你面对的是哪种项目。
她的观察是:以前大公司才有的问题,现在变成了所有人的问题。
她在 Meta 待过,那里有一个巨大的单体仓库,几万名工程师同时提交代码。她说你可能想不到,那里的代码质量其实并不怎么样。她开玩笑说,在 AI 写出垃圾代码之前,人类早就在写垃圾代码了。
所以大公司的基础设施本来就是为团队里能力最弱的那个人设计的:框架、约定、护栏、权限隔离,防止实习生一不小心删掉生产数据库。如果你的项目已经有这些东西,agent 其实已经能干得不错,因为护栏早就在那里了。
风险最大的是全新的项目。Grok Bot 最早就是快速 vibe coding 出来的原型,几乎没有人在读代码。她把这种状态叫作有机架构:没有任何护栏,agent 每次都会选当下最省事的写法,时间一长,代码库就失控了。你看不懂它,agent 某种程度上看得懂,但它搭出来的东西是为走捷径优化的。
所以她花了 600 多个 PR,把整个 Grok Bot 重构到一套新架构上,内部代号叫 Dune。可以把它理解成专门给 Electron 应用用的、为 agent 编写而设计的 Next.js。
先承认 agent 的习惯
Dune 设计文档:先写清 agent 的行为习惯
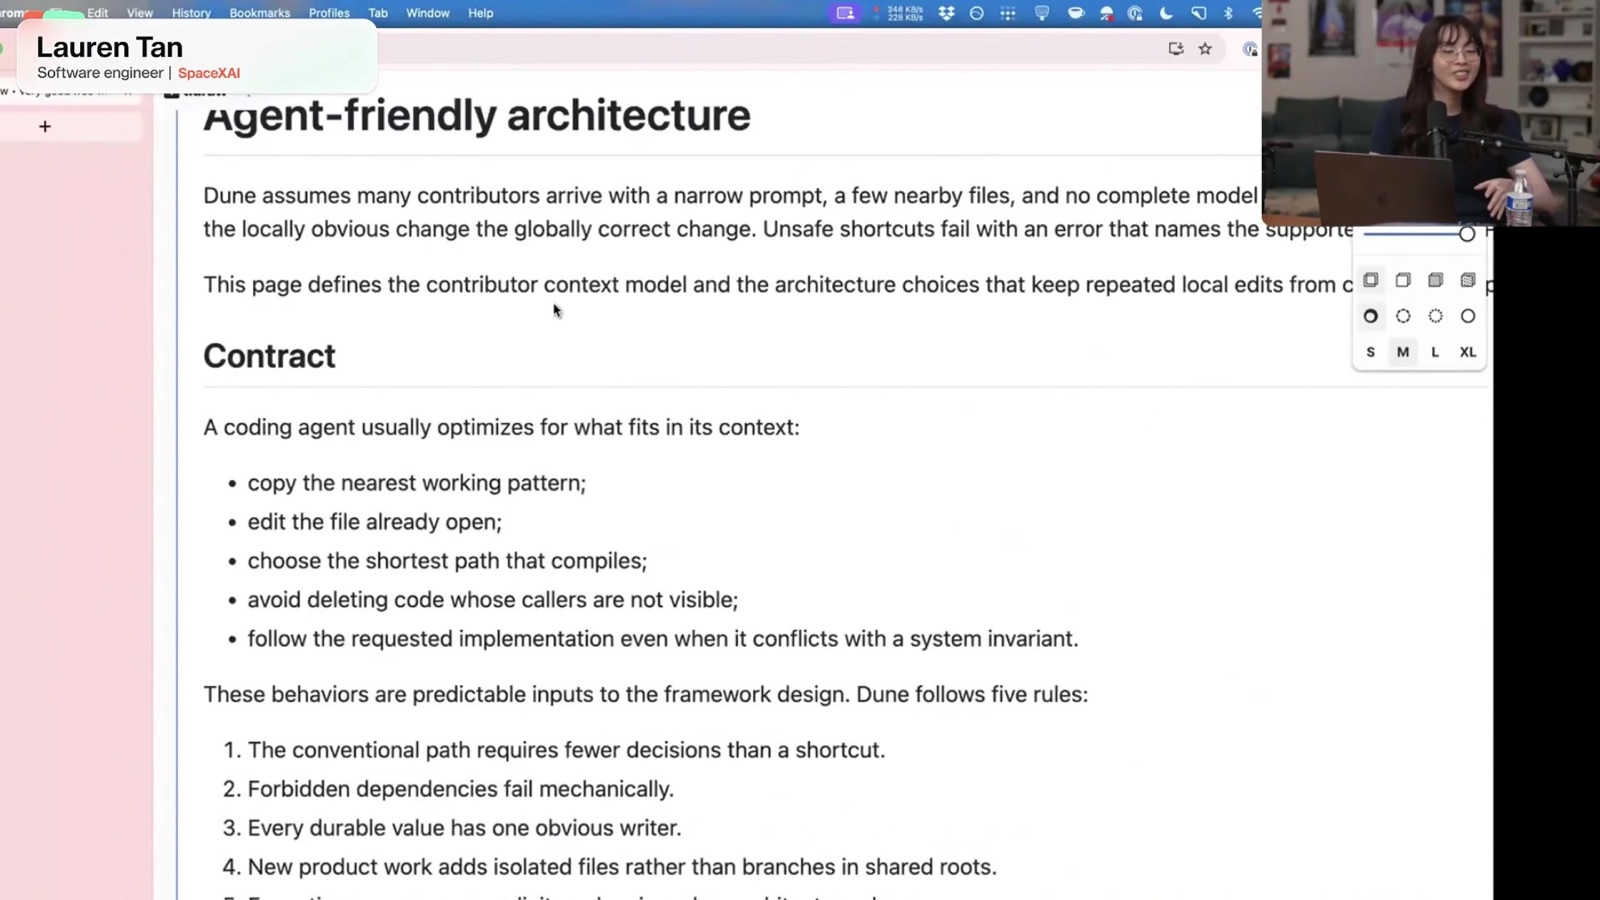
Dune 的设计文档开头写了一份合约,先承认 coding agent 会优化「能装进上下文的东西」,所以它通常会:
复制离它最近的一段能跑的代码。
直接改已经打开的那个文件。
选择能编译通过的最短路径。
不敢删除看不到调用方的代码。
照着你要求的实现方式去做,哪怕它和系统的不变量冲突。
文档里说,这些行为是可以预测的,所以可以当成框架设计的输入。Dune 据此定了五条规则:
按约定走的路径,要比走捷径需要做的决定更少。
禁止的依赖关系,要能被机器自动拦下来。
每个需要持久保存的值,只有一个明确的写入方。
新的产品功能以新增独立文件的方式加进来,而不是在共享的根文件里加分支。
例外情况要范围很窄、写得明确,并且作为架构变更来审查。
她用一句话概括这套框架的原则:最短的路径就是最好的路径。agent 天生爱走捷径,那就让捷径本身成为正确的做法。
几条具体的禁令
她分享了几条 Dune 里的硬性规定,CI 会直接报错:
禁用 useEffect。写过 React 的人都知道,这是最容易出问题的地方之一。
禁止写代码注释。这一条很多人会惊讶。她的理由是,99% 的情况下 agent 写的注释都在描述一些跟代码无关的历史。比如她在某次 review 里说过「这里不要这样写」,agent 就会在代码里留一句「Lauren 说过永远不要这样做」。她说那只是针对那个 PR 的意见,不是一条全局规则。
强制隔离 Electron 的主进程和渲染进程。代码目录直接分成 electron main 和 electron renderer,CI 会检查依赖图,不允许跨目录导入。原因是 agents window 经常出现性能退化:想要 60 帧,每一帧必须在 16 毫秒内画完,一旦有计算量大或者有 IO 的代码被意外拉进渲染线程,就会掉帧卡顿。这些踩过的坑,现在都被写成了硬性失败。
一个功能一个目录。每个功能的所有代码都放在同一个目录里,agent 接到任务,直接进那个目录干活,80% 的工作都不用跨出去。
她说在 Grok Bot 里写代码其实非常烦人,约束和 CI 到处都是。但这些烦人的部分,全被 agent 吸收掉了。
六、五层约束,只有前两层算数
她把一个好代码库的约束分成五层:
代码库本身的结构和约定
静态分析:lint、编译器、CI
规则文件和 Bugbot(Cursor 的自动代码审查)
技能
风格指南
Dune 的五条规则,下方是她手写的约束分层
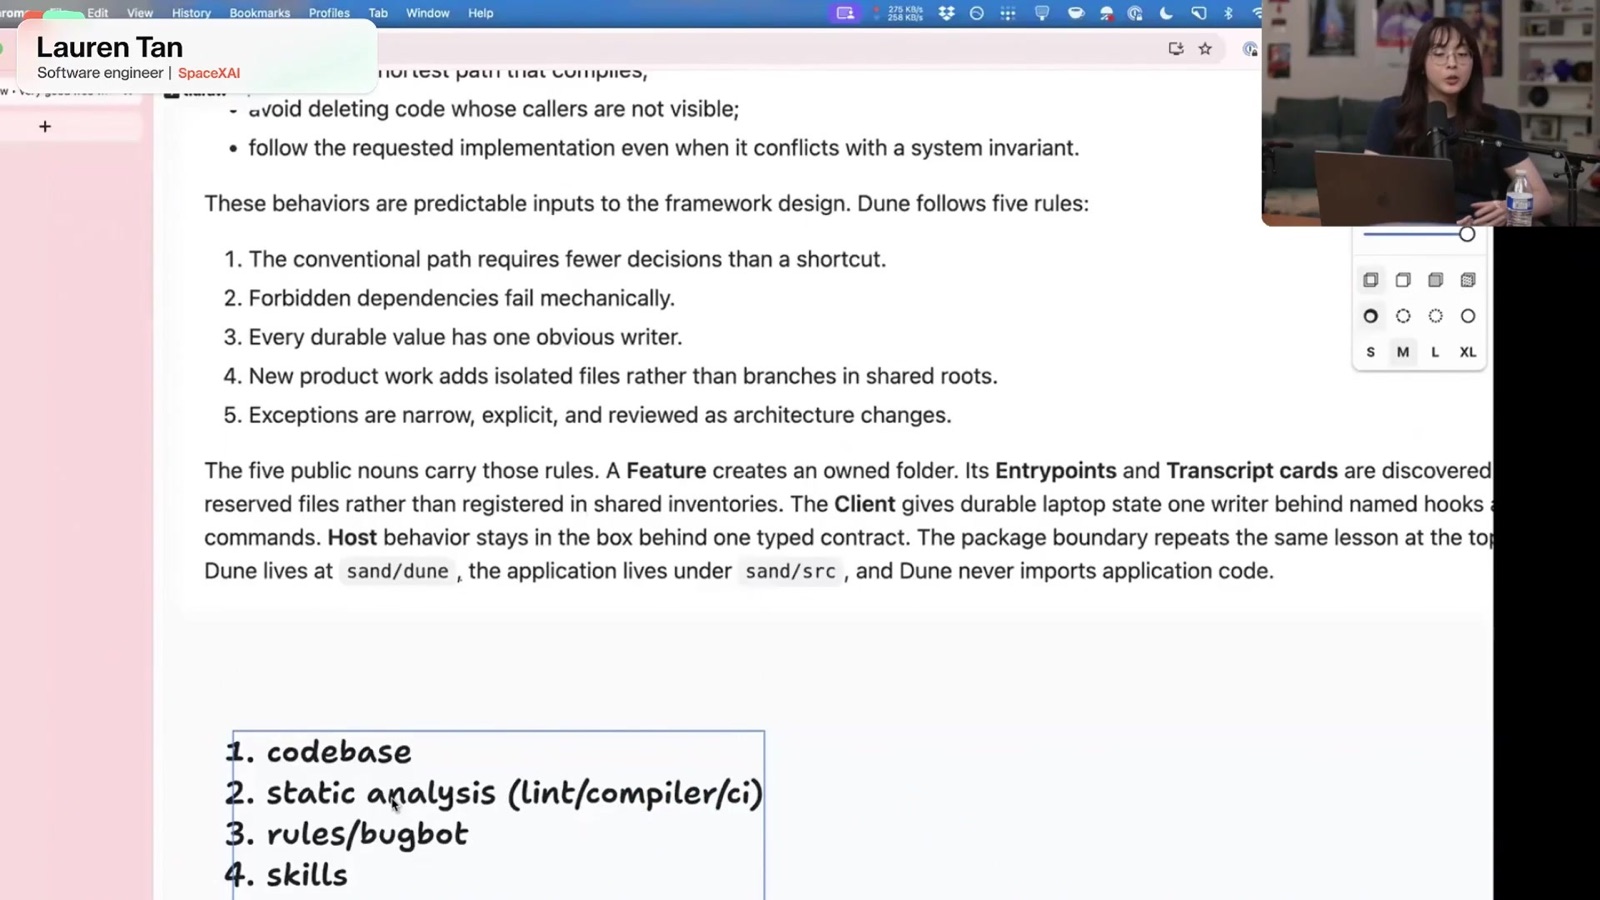
前两层是硬约束,违反了 CI 就会变红。后三层是软约束,agent 可能会忘,也可能执行得不一致。她会把五层都叠上去,但从不只依赖后三层。她的原话很直接:如果你只有规则、Bugbot、技能和风格指南,代码库变成一堆垃圾只是时间问题。
她也提到,这也是为什么技术栈的选择越来越重要。Rust 最近重新火起来,一个原因就是编译器足够严格。只要不让 agent 写 unsafe 代码块,能编译通过的代码大概率就是能用的,人就不用再逐行检查。
最糟糕的状态,是所有约束都靠人在 code review 里一条条指出来。她的建议是把每一次 review 评论都当成一个坏味道。每次你想在 PR 里写「这里不要这样做」,先问自己:
能不能把它变成一条 lint 规则?
能不能把它变成一个 CI 失败?
能不能从根上让这类问题不可能出现?
PR 拆小一点
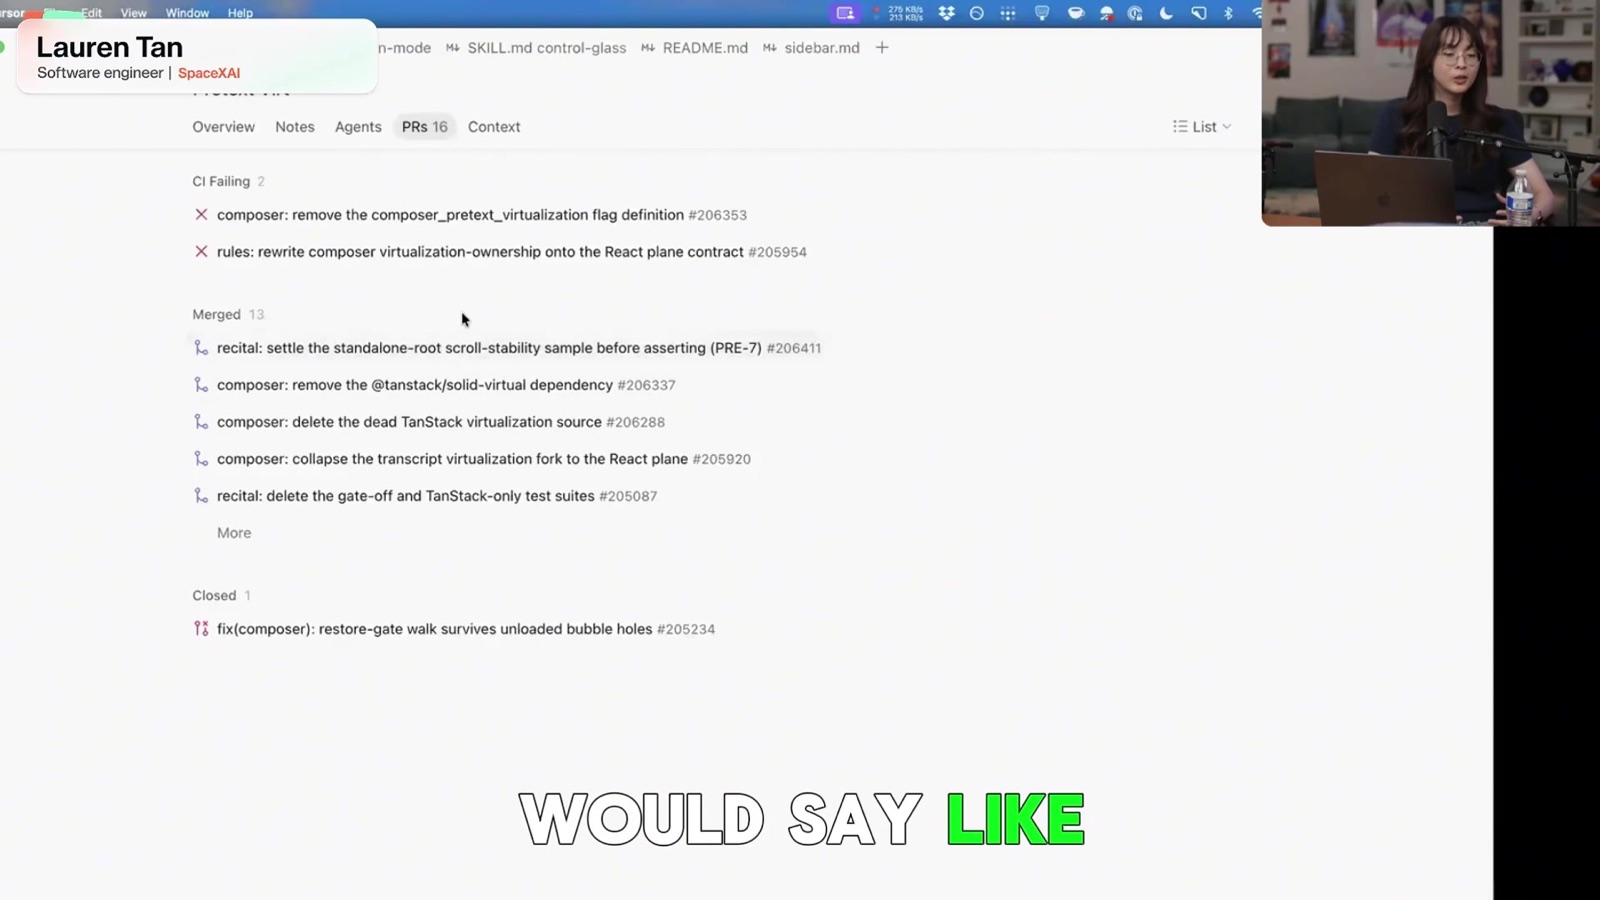
有人问她的 PR 一般多大。她说没有硬性上限,从五十行到一千行都有,但她会要求 agent 把工作拆成多个 PR。原因有两个:git 历史本身是很有价值的上下文,每个 PR 最好只描述一件小事;出了 bug 也更容易定位和回滚,不用在一个四万行的 PR 里大海捞针。
她演示的 PR 列表:CI 失败、已合并、已关闭
七、这笔 token 账划算吗
现场被问得最多的问题是:普通人没有无限 token,这套做法现实吗?
她先承认,自己在 AI 实验室工作,token 是不限量的,所以不能说每个人都应该照搬她的做法。但她认为不花大钱也能走到这一步。
她把它当成一笔投资回报来算。前期确实要花很多 token,重构代码库、加约束、写技能都很贵。但另一个选项是招人。她说如果在没有 agent 的年代,让她一个人去搭这套框架、做完所有重构、测试和验证,要花好几年,而且她的工资并不低。
一旦约束到位,就连能力一般的模型也能把代码写得很好,不需要每次都用最大的模型。她认为团队应该保持精简,别变成一个上万人的工程组织。agent 最大的价值,是让你做到以前做不到的事。在每件小事上抠 token,意义不大。
八、最后的回报
她最兴奋的部分,是这套架构让不懂工程的人也能贡献代码。
在 Grok Bot 团队里,PM、设计师甚至 GTM 同事都会直接提交修复。PM 发来一个 PR 说「这里有个 bug,我修了,你看看」,她打开一看,没问题,直接通过。她说这说明 Dune 架构顶住了,严格的约束让非专业的人也能写出高质量的代码。
她还提到,Grok Bot 对不写代码的人来说,就像当年 Cursor 对开发者那样。界面像 iMessage,每个 agent 可以有自己的名字,你可以让一个 agent 负责一个客户,或者让一个 agent 每天早上总结她昨晚都干了什么。
如果你明天就想开始
把她的方法压缩成能马上做的四件事:
给你的应用做一个验证技能,让 agent 能自己把程序跑起来、操作、截图、抓日志。先在本地做,盯着它跑。
给验证技能配一份功能地图,一个功能一个文件,写清楚从用户视角怎么到达。
每纠正 agent 一次,就把那次纠正写成一个技能。每改一次技能,就跑一遍 eval。
每写一条 review 评论,就想办法把它变成 lint、CI 或者架构层面的硬约束。
做完这些,再考虑把 agent 搬到云端,再考虑同时开更多。
她在分享里反复回到同一个词:信任。每个工程师都有自己的标准,对自己的代码库在意的东西也不一样。把这些标准写成技能和约束,再确认 agent 真的在遵守,你才能沿着那条曲线往上走。
模型几个月就会换一代,你搭起来的这套验证、技能和约束,换了模型也照样能用。
你现在同时在跑几个 agent?卡在曲线的哪一段?
内容整理自 Lauren Tan 的公开分享视频。文中提到的 pstack 可以搜索pstack cursor找到。
再次感谢分享!!!